pi膮tek, 8 listopada 2024

Observability

Tradycyjne metody monitoringu przesta艂y by膰 wystarczaj膮ce w dobie z艂o偶onych system贸w - wymagane jest bardziej wnikliwe zrozumienie system贸w oraz przy艣pieszanie rozwi膮zywania incydent贸w.

Sama implementacja system贸w obserwowalnych i ich utrzymanie rodzi nowe problemy. Zewn臋trzne systemy s艂u偶膮 do obserwowania aplikacji; kwestionowanie w celu poznania wewn臋trznej pracy systemu i stanu systemu.

Je偶eli mamy mo偶liwo艣膰 pozyskania informacji na temat stanu aplikacji w ka偶dym jej aspekcie nawet z kt贸rymi byli艣my nie zaznajomieni jeszcze jaki艣 czas temu, kt贸rych nie przewidzieli艣my - a przysz艂y nam one dopiero teraz i mamy mo偶liwo艣膰 zweryfikowania tych偶e danych. Oznacza to, 偶e wska藕nik Observability systemu jest wysoki.

Stale musimy usprawnia膰 proces zwi臋kszania wska藕nika Observability; dzi臋ki wysokiemu Observability mo偶emy wypatrywa膰 niecodziennych/podejrzanych wzorc贸w i zachowa艅; pozwala na analiz臋 interakcji u偶ytkownika z systemem; dzi臋ki Observability mamy wgl膮d w dynamik臋 komunikacji mi臋dzy mikro serwisami/kontenerami; taka analiza powinna by膰 standardowym elementem pracy programist贸w (development life-cycle). Observability daje mo偶liwo艣膰 wgl膮du w zachowanie systemu, dzi臋ki tym informacj膮 deweloperzy mog膮 poprawia膰 niezawodno艣膰/wydajno艣膰 systemu; analiza log贸w, metryk, trace’贸w pozwala na zidentyfikowanie bottleneck’贸w wydajno艣ciowych;

Kluczowe koncepty:

  • Root cause analysis
  • Highly observable system (has intricate details/critical insights)
  • Realtime monitoring/alerting
  • resource utilization
  • error rates
  • Synthetic Journeys
  • performance metrics
  • deviations from normal patterns
  • APM (Application Performance Monitoring)
  • application dependencies,
  • Distributed tracing - z艂o偶one systemy gdzie pojedynczy request oddzia艂uje na wiele mikro serwis贸w w r贸偶nych data centers - taki trace ma sw贸j ID
  • Telemetry Instrumentations (Open Telemetry Standard) event wysy艂any do central location (tracking user journey; troubleshooting errors)
  • Site Reliability Engineering (SRE)
  • feature flagging
  • incident analysis
  • blue-green deployment
  • chaos engineering; “pytania kt贸re zostan膮 postawione bez wcze艣niejszej wiedzy”
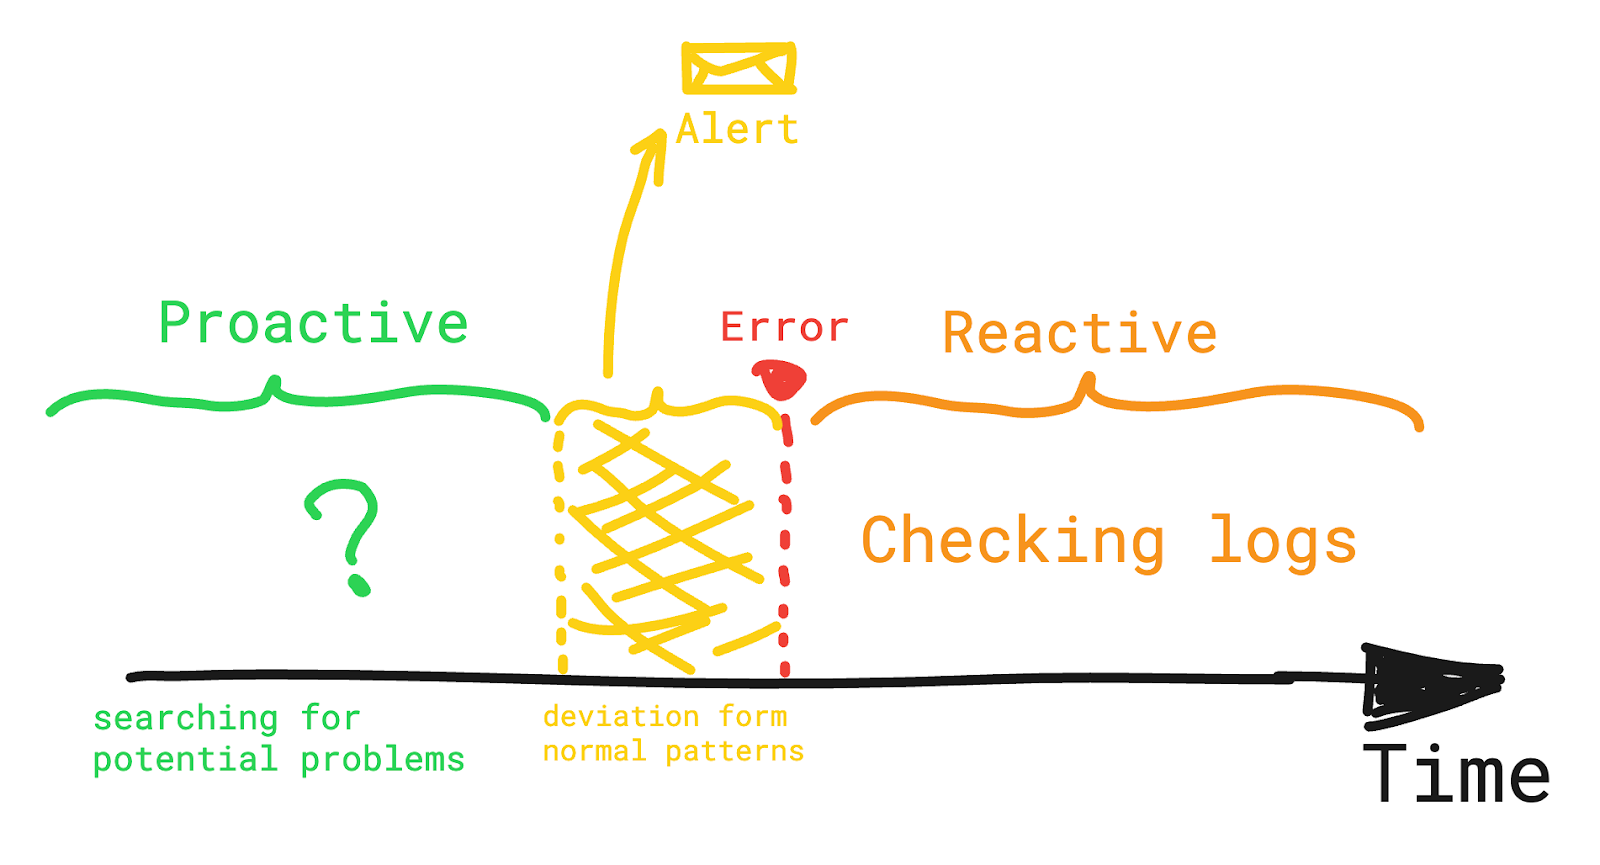
  • alert ➡️ warto艣膰 progowa predefiniowanej metryki zosta艂a przekroczona; remediations (艣rodki zaradcze)
  • podej艣cie reaktywne: zidentyfikowanie i rozwi膮zanie problemu po tym jak wyst膮pi
  • podej艣cie proaktywne
Observability pomaga zrozumie膰 wewn臋trzne zachowanie systemu co mo偶e wy艂oni膰 potencjalne problemy kt贸re b臋d膮 mie膰 miejsce w przysz艂o艣ci.

Alert musi mie膰 dane dot. powodu jego wyst膮pienia (moje do艣wiadczenie: miejsce wyst膮pienia, dane kontekstowe - zasobu kt贸rego dotyczy).

Tradycyjny monitoring i dashboardy polegaj膮 na wiedzy Seniora (dependency on human expertise) - czyli metodologia (tradycyjny monitoring) polegaj膮ca na objawach ani偶eli na actual Root Cause - to nie mo偶e by膰 d艂u偶ej stosowane gdy z艂o偶ono艣膰 i skala jest du偶a; “Information to debug issues in details”, “ask open questions”, “trace the system to find real cause of problems (deeply hidden)”; organizacja nie polega na wiedzy eksperta i na subiektywnym zgadywaniu, a prowadzi do bardziej obiektywnej analizy; Z艂o偶one interakcje mi臋dzy systemami rozproszonymi; metrics, events, logs, traces, telemetry data - unforeseen issues. Szybkie rozwi膮zanie problemu to ograniczenie down-time; identify & solve potential issue before they affect users - w przeciwie艅stwie do reagowania na problem; Problemy z Observability: przechowywanie tych danych, przesy艂anie tych danych po sieci; zmiana sposobu my艣lenia z re na pro; observability kosztuje; security & privacy; 


殴r贸d艂o 

sobota, 14 stycznia 2023

Kontekst pierwotny, a reu偶ywalno艣膰 obiektu

By oszcz臋dzi膰 sobie czasu i korzysta膰 z przychylno艣ci programowania obiektowego – kod kt贸ry napiszemy raz, mo偶emy ponownie wykorzysta膰 w nowych przypadkach. My艣l臋 偶e zasada DRY, zawsze siedzi nam z ty艂u g艂owy i zna j膮 ka偶dy zawodowy programista. Niestety w programowaniu nic nie jest czarno-bia艂e i po latach pracy nad r贸偶nymi projektami pojawi艂o si臋 kilka w膮tpliwo艣ci co do 艣lepego stosowania DRY.

Co robi metoda i dlaczego?

Rola obiektu jest w艂a艣ciwie kontekstem jego wywo艂ania. Przeanalizujmy przypadek w kt贸rym posiadamy Encje/WriteModel Product z jeszcze nienazwan膮 metod膮:

namespace App\Offer\Domain\Entity;

final class Product 
{
	/* ... */
	
	public function ____________(): array 
	{
		return [
			'name' => $this->name,
			'description' => $this->description,
			'price' => $this->price,
			'currency' => $this->currency,
			'created_at' => $this->createdAt->format('Y-m-d H:i:s')	
		];
	}
} 

Co mo偶emy odczyta膰 z tego kodu?

    • metoda zwraca
array’a kt贸ry jest struktur膮 danych. Dodanie do niej @docBlock - /** @return array<string, mixed> */ nie wiele wniesie do klient贸w bo i tak by nie iterowali po zwr贸conej przez metod臋 tablicy,
    •
array b臋d膮cy struktur膮 danych budowany jest na podstawie wewn臋trznego stanu obiektu. Na przyk艂adzie tego nie wida膰, ale za艂u偶my, 偶e serializacji podlega ka偶de pole klasy,
    • Jest to metody typu Query (CQS) – niemodyfikuj膮ca wewn臋trznego stanu obiektu czyli pozbawiona efekt贸w ubocznych.

Kolejne wnioski mo偶emy wyci膮gn膮膰 patrz膮c na (jak dot膮d) jedynego klienta korzystaj膮cego z tej metody:

namespace App\Offer\Infrastructure\Repository;

use App\Offer\Domain\Repository\ProductRepository;
use App\Offer\Domain\Entity\Product;
use Doctrine\DBAL\Connection;

final class ProductMySQLRepository implements ProductRepository
{
	public function __construct(private Connection $connection) {}
	
	public function save(Product $product): void 
	{
		$this->connection->executeStatement(
			'INSERT INTO product ...',
			$product->____________()
		);
	}
}


    • nienazwana metoda wywo艂ywana jest w Warstwie Infrastruktury,
    • zmapowany stan Write Modelu reprezentowa艂 b臋dzie jeden wiersz w tabeli product,

Bior膮c pod uwag臋 fakt, 偶e klasa
ProductMySQLRepository jest jedynym klientem metody Product::__________ - mo偶emy za艂o偶y膰, 偶e powsta艂a ona specjalnie by by膰 wykorzystana do utworzenia wiersza w tabeli. Programista stan膮艂 przed problemem – „jak mog臋 utrwali膰 Encj臋 Product – nie tworz膮c dla niej ca艂ej armi getter贸w?”. Za艂贸偶my, 偶e zdecydowa艂 si臋 utworzy膰 metod臋 mapuj膮c膮 stan na dane oczekiwane przez drugi parametr Doctrine’owego Connection::executeStatement. Czy nie przewiduj膮c dla niej innego wykorzystania (w tym punkcie czasu) w przysz艂o艣ci, wywo艂anie jej w innym kontek艣cie – ca艂kowicie innym ni偶 INSERT bazodanowy – b臋dzie akceptowalne?

Jaka nazwa jest najodpowiedniejsza?

Do wyboru mamy:
    1.
toArray
    2.
asArray
    3.
serialize
    4.
jsonSerialize
    5.
map

Takie podej艣cie sprawia, 偶e w nazwie metody nie ma 艣ladu po kontek艣cie jej u偶ycia, a kt贸ry jest w ca艂ej historii powstania tej metody bardzo istotny. Bezkontekstowa nazwa metody sprawia z艂udne wra偶enie, 偶e wykorzystanie jej ponownie w zupe艂nie innym kontek艣cie, w zupe艂nie innej roli jest ca艂kowicie usprawiedliwione.

Powinni艣my wi臋c odpowiedzie膰 sobie na jedno pytanie: „Czy nazwa metody powinna okre艣la膰 intencje jej pierwotnego u偶ycia?” - moim zdaniem nie. Niezmienia to jednak wspomnianej ju偶 wielokrotnie istotno艣ci kontekstu dla kt贸rego zosta艂a wprowadzona, na kt贸rego musimy zwraca膰 uwag臋 podczas ponownego u偶ycia metody.
 
Na potrzeby omawianego przyk艂adu mo偶emy ustali膰, 偶e
asArray b臋dzie prawdziw膮 nazw膮 Product::__________ metody. Dlaczego akturat ta nazwa zosta艂a wybrana spo艣r贸d innych? - mo偶na powiedzie膰, 偶e chodzi o konwencje w projekcie. Cz臋sto musimy serializowa膰 obiekty do tabel, powody tego s膮 r贸偶ne. Tak jak w opisanym przyk艂adzie, raz potrzebujemy przes艂a膰 dane do tabeli bazodanowej, innym razem wys艂a膰 je poza aplikacj臋. Musimy przyj膮膰 jedn膮 konwencj臋 nazewnicz膮 dla tego typu metod – na co kolwiek si臋 ostatecznie zdecydujemy, nie b臋dzie mia艂o ostatecznego wp艂ywu na jako艣膰 projektu.   

Jeden obiekt – dwa konteksty u偶ycia

Zapisywanie produktu do bazy danych zosta艂o wdro偶one na produkcj臋 miesi膮ce temu. Biznes jednak nie pozostawi艂 tematu na zawsze i postanowi艂 wzbogaci膰 modu艂 oferty o nowy feature. Na ka偶de dodanie nowego produktu mia艂 by膰 wysy艂any email do zewn臋trznego systemu z szablonem umo偶liwiaj膮cym dynamiczne dodanie danych produktu. Podczas tworzenia templatki, mo偶na by korzysta膰 z zestawu kluczy, kt贸rych warto艣ci zawsze by艂yby dost臋pne wraz z wysy艂anym emailem. By jeszcze skomplikowa膰 spraw臋, za te czynno艣ci (wysy艂anie emaili i zarz膮dzanie templatkami) odpowiedzialny by by艂 zewn臋trzny system.   


Spogl膮daj膰 na kod odpowiedzialny za zapisywanie produktu sprawa wygl膮da do艣膰 prosto bo... 

namespace App\Offer\Application\Handler;

use App\Offer\Domain\Entity\Product;
use App\Offer\Domain\Repository\ProductRepository;

final class CreateProductHandler 
{
	public function __construct(
		private ProductRepository $productRepository;
	) {}

	public function __invoke(/*...*/): void 
	{
		/*...*/
		$this->productRepository->save($product);
	}
}

...jedyne co musimy zrobi膰 to wstrzykn膮膰 serwis odpowiedzialny za komunikacj臋 z zewn臋trznym serwisem wysy艂aj膮cym emaile. Jako 偶e mamy obiekt $product pod r臋k膮, wraz z mo偶liwo艣ci膮 jego 艂atwej serializacji do struktury tablicowej – mo偶emy pokusi膰 si臋 o implementacj臋 z jego wykorzystaniem. Metoda __invoke potrafi膮ca zleca膰 wysy艂k臋 email’a wyglada nastepuj膮co:

public function __invoke(/*...*/): void 
{
	/*...*/
	$this->productRepository->save($product);
	$this->externalEmailService->send($adminEmail, $product->asArray());
}

W tym momencie struktura tablicowa zwracana przez metod臋 Product::asArray jest wykorzystywana dwuktornie w r贸偶nych  kontekstach:
    1. zapisu wiersza tabeli bazy MySQL,
    2. templatce emaila znajduj膮cego si臋 w zewn臋trznym systemie  

Jak pokazuje poni偶szy kod w zewn臋trznym systemie znalaz艂y si臋 „poj臋cia” zwi膮zane z wewn膮trz-systemow膮 reprezentacj膮 zapisu encji z innego systemu.

Utworzono produkt {{name}}

{{created_at}}

{{description}}

Rozwa偶my plusy i minusy

✅ nie musimy robi膰 nic wi臋cej ni偶 wywo艂anie metody kt贸ra zosta艂a ju偶 wcze艣niej napisana. Nazwa metody serializuj膮cej nie zawiera w sobie 偶adnego kontekstu w kt贸rym zosta艂a utworzona dlatego korzystamy z niej z czystym sumieniem,

❌ powi膮zali艣my ze sob膮 niejawnie dwa konteksty: zmiana klucza w zserializowanym produkcie wprowadzona na potrzeby kontekstu bazodanowego, b臋dzie mia艂a te偶 swoje konsekwencje w kontek艣cie zewn臋trznego serwisu do wysy艂ki emaili. Ewentualne zmiany, kt贸re musz膮 by膰 wprowadzone tylko w jednym z kontekst贸w b臋d膮 wymaga艂y wprowadzenia ma艂ych hack贸w,
❌ do zewn臋trznego serwisu wysy艂aj膮cego emaile mog膮 trafi膰 nadmiarowe/poufne dane, by膰 mo偶e o nieodpowiednich nazwach kluczy. Mo偶emy tego unikn膮膰 stosuj膮c drobne hacki – przemapowanie tablicy, unsetowanie,
❌ korzystamy z metody utworzonej w celu utrwalaniu Write Modelu – w spos贸b jakiego nie zak艂ada艂 jej tw贸rca. Traktuj膮c zwracany array jako View Model,
❌ Gdyby艣my zdecydowali si臋 na wysy艂k臋 emaila w Event Subscriberze nie mieliby艣my takiego 艂atwego dost臋pu do encji $product jak wcze艣niej. Musieliby艣my albo pozyska膰 j膮 z repozytorium  i w dalszym ci膮gu, z uporem maniaka korzysta膰 z niej jak z Read Modelu.
 

Z pozoru prostrze rozwi膮zanie mo偶e powodowa膰 wi臋cej problem贸w w przysz艂o艣ci ni偶 rozwi膮zuje teraz.

View Model w nowym kontek艣cie

By uchroni膰 si臋 przed silnym couplingiem pomi臋dzy dwoma wspomnianymi kontekstami, nie mo偶emy ca艂y czas polega膰 na jednej tablicowej strukturze danych. Musimy wprowadzi膰 nowy byt, a z racji tego, 偶e zserializowana encja Product by艂a pocz膮tkowo wykorzystywana w kontek艣cie zapisu danych do tabeli bazodanowej – t膮 cz臋艣膰 pozostawimy w pierotnej postaci. W kontek艣cie wysy艂ki maili zostanie utworzona nowa klasa typu View Model.

Obiekty tego typu:
    • stanowi膮 warstw臋 buforow膮 pomi臋dzy rdzeniem naszej aplikacji, a 艣wiatem zewn臋trznym,
    •  s膮 niemutowalne, s艂u偶膮 jedynie jako struktura danych bez 偶adnych zachowa艅,
    • powinny posiada膰 odpowiednio sformatowane dane przeznaczone dla klienta.

Przyk艂adowa implementacja mog艂aby prezentowa膰 si臋 nast臋puj膮co:
namespace App\Offer\Application\ViewModel;

final class ProductEmail 
{
	public function __construct(
		private string $name,
		private string $description,
		private float $price,
		private string $currency,
		private DateTimeImmutable $createdAt
	) {}
	
	public function asArray(): array 
	{
		return [
			'name' => $this->name,
			'description' => $this->description,
			'price' => number_format($this->price) . ' ' . strtoupper($this->currency),
			'createdAt' => $this->createdAt->format('Y-m-d H:i:s')	
		];
	}
}

Jak wida膰 klucze jak i formatowanie udostepnianych danych s膮 specjalnie dostosowane pod wymagania byt贸w ze 艣wiata zewn臋trznego. Nie jeste艣my teraz od niczego zale偶ni, dlatego na nowe wymagania biznesowe mo偶emy dowolnie zmienia膰 serializacj臋 View Modelu – dodawa膰 nowe klucze, modyfikowa膰 nazwy ju偶 istniej膮cych jak i zmienia膰 foramtowanie samych warto艣ci. Problemem mo偶e okaza膰 si臋 samo instancjonowanie tego obiektu, najpewniej w metodzie repozytorium powi膮zanym z Encj膮 Product, niemniej jednak jest to niewielki koszt za cen臋 dobrego designe’u.

Koszt jaki musimy ponie艣膰 to:

馃挵 Utworzenie nowej klasy View Model’u
馃挵 Instancjonowanie VM, najpewniej w nowej metodzie repozytorium
馃挵 dodaj膮c do Encji
Product nowe pole, nie doda si臋 ono automatycznie do View

Modelu co mia艂oby miejsce w pierwszej inkarnacji „Wysy艂ki emaila na utworzenie produktu”. Niew膮tpliwie rozpatrujemy to jako zalet臋, ale r贸wnie偶 jako koszt – rzeczy o kt贸rej nale偶y pami臋ta膰 i pot臋cjalnie wykona膰.

Z艂o偶ono艣膰

Mo偶emy odnie艣膰 wra偶enie, 偶e wraz z dodawaniem kolejnych klas/metod ro艣nie z艂o偶ono艣膰 projektu. W tym przypadku jest to z艂udne wra偶enie. Pomy艣lmy, korzystaj膮c z jednej struktury tworzymy silny coupling pomi臋dzy modu艂ami, kt贸re nie powinny by膰 ze sob膮 powi膮zane na tym poziomie:

Dodajemy nowe pole do Encji Product ➡️ pojawia si臋 nowy klucz mo偶liwy do wykorzystania w templatce emaila.


lub:

Usuwamy pole z Encji Product ➡️ Zewn臋trzny System przestaje wysy艂a膰 emaile o utworzeniu produktu.


I z szerszej perspektywy:

Modyfikujemy Domen臋 w Module Offer ➡️ Zewn臋trzny System do emaili przestaje dzia艂a膰.


Nowy programista w projekcie, m贸g艂by przeoczy膰 ten fakt i nie by膰 nawet 艣wiadom takiego efektu ubocznego podczas dodawania nowego atrybutu Encji. Tego typu nieprzewidziane efekty uboczne s膮 przyczyn膮 powstania trudnych do wytropienia b艂臋d贸w, sprawiaj膮c, 偶e z艂o偶ono艣膰 oprogramowania ro艣nie.

Czas zweryfikowa艂: rola jest jedna

Osobne byty dla innych kontekst贸w daj膮 niesamowit膮 swobod臋, ale je偶eli pocz膮tkowo s膮 identyczne i za ka偶dym razem trzeba nanosi膰 takie same zmiany do dw贸ch klas – znaczy, 偶e nie powinni艣my w og贸le wprowadza膰 takiego rozdzielenia, bo pierwotny obiekt odgrywa tak膮 sam膮 rol臋 w dw贸ch kontekstach. 

Podsumowanie

Tak jak zosta艂o wykazane w opisywanym przypadku, by usun膮膰 z艂o偶ono艣膰 i ukryty coupling, musia艂y by膰 utworzone dodatkowe byty. W konsekwencji tego, mog膮 pojawia膰 si臋 g艂osy innych cz艂onk贸w team’u:

Czasami trudno jest przewidzie膰 konsekwencje niekt贸rych decyzji podczas implementacji. Dlatego warto czasami zatrzyma膰 si臋 i przemy艣le膰 niekt贸re kwestie, jakie b臋d膮 ich konsekwencj臋. Z pozoru „skomplikowanie” projektu dodaniem kilki nowych klas mo偶e okaza膰 si臋 zabawienne w czasie jego dalszego 偶ycia. Zach臋cam wi臋c do przemy艣le艅 w tej kwestji.


sobota, 7 stycznia 2023

Weryfikacja stanu obiektu gdy stan nie jest ujawniony


Spotka艂em si臋 ostatnio z ciekawym przypadkiem weryfikowania wyniku testu jednostkowego. Testowaniu zosta艂a poddana void'owska metoda Agregatu i nijak nie mo偶na by艂o wyci膮gn膮膰 na zewn膮trz stanu obiektu, kt贸ry powinien ulec zmianie w wyniku wywo艂ania metody under test, by mo偶na by艂o go zweryfikowa膰 z oczekiwaniami. Agregat nie posiada艂 powi膮zanych z tym stanem getter'贸w, wygenerowane event'y nie mog艂y zosta膰 jawnie zwr贸cone poza obiektu (\Prooph\EventSourcing\AggregateRoot tego nie udost臋pnia艂) i 偶adna inna metoda jakkolwiek nie wyrzuca艂a stanu na zewn膮trz. Dodanie takich funkcji na si艂臋, tylko na potrzeby wykonania testu jednostkowego wydawa艂o si臋 nadu偶yciem wi臋c te偶 takie rozwi膮zanie nie wchodzi艂o w gr臋.

Przez powy偶sze problemy, trzeba by艂o wykaza膰 si臋 pomys艂owo艣ci膮 by napisa膰 test - kolega z zespo艂u wpad艂a na takie oto rozwi膮zanie:

public function test(): void
{
    $objectUnderTest = new Person('Jan', 'Kowalski');

    // When
    // ...

    Closure::fromCallable(function () {
        TestCase::assertSame('Jan', $this->firstName);
        TestCase::assertSame('Kowalski', $this->lastName);
    })->bindTo($objectUnderTest, Person::class)();
}

Gdy pierwszy raz zobaczy艂em takie podej艣cie by艂em zaskoczony 偶e tak si臋 da, zaraz potem uzna艂em 偶e tak nie powinno si臋 robi膰. Tyle raz powtarzano, 偶e testowaniu powinno podlega膰 jedynie publiczne API obiektu, a jego wewn臋trzny stan powinien zosta膰 w ukryciu... i jest to m膮dre podej艣cie. Dzi臋ki temu mamy woln膮 r臋k臋 w przeprowadzaniu refaktoru - raz napisany test, daje nam mo偶liwo艣膰 weryfikowania czy ulepszanie wewn臋trznej struktury obiektu po zmianach dzia艂a dalej tak jak tego oczekujemy.   

To rozwi膮zanie 艂ami臋 zasad臋, wi膮偶膮c test z ukrytymi przed reszt膮 kodu produkcyjnego wn臋trzno艣ciami Agregatu. Potem jednak zacz膮艂em si臋 zastanawia膰 na ile realnie problematyczny b臋dzie on w utrzymaniu i czy czasem od dawna nie mierzymy si臋 z tego typu problemami.

馃敀 Kod produkcyjny dalej nie wie o stanie Agregatu

Niew膮tpliw膮 zalet膮 zastosowania metody Closure::bindTo jest fakt, 偶e nie wp艂ywa ona w 偶adnym stopniu na kod produkcyjny. Nie utworzyli艣my specjalnych getter'贸w wykorzystanych tylko na potrzeby test贸w co w przysz艂o艣ci mog艂oby sk艂oni膰 innych developer贸w do skorzystania z nich. W pewnym stopniu getter jest form膮 udost臋pniania warto艣ci 1:1 z tym co jest wewn臋trznym stanem obiektu. Dodanie getter'a wygl膮da jak rozszerzenie publicznego API, ale tylko na poz贸r. Bo je偶eli zmienimy wewn臋trzny stan to b臋dziemy musieli zmieni膰 owego getter'a. Mo偶na by zastanowi膰 si臋 nad innymi realnymi problemami z tym zwi膮zanymi, ale jest to temat na inny wpis.   

W ka偶dym razie wydaje mi si臋, 偶e problem tworzenia takich getter'贸w istnieje w 艣wiatku PHP, jest stosunkowo cz臋sto stosowany i tylko sprawia wra偶enie niegro藕nego - dlatego powinni艣my zwraca膰 na to uwag臋. 

Stosowanie Closure::bindTo zamias dedykowanych getter贸w chroni kod produkcyjny.

馃嚞馃嚙 Szko艂a Londy艅ska

Pisz膮c test jednostkowy klasy typu serwis (np. Event Subscriber'a, Command Handler'a) wed艂ug paradygmat贸w tz. Szko艂y Londy艅skiej musimy najpierw zamockowa膰 jego zale偶no艣ci. Mo偶na to zrobi膰 za pomoc膮 customowych implementacji InMemoryRepository b膮d藕 przy u偶yciu narz臋dzi takich jak Prophecy/MockObject.

I tutaj w艂a艣nie zacz膮艂em dostrzega膰 podobie艅stwo wzgl臋dem opisywanego przyk艂adu. Dok艂adnie wiemy jak w te艣cie jednostkowym nale偶y zbudowa膰 zale偶no艣膰 wymagan膮 przez object under test oraz jak b臋dzie wygl膮da艂a interakcja pomi臋dzy zale偶no艣ci膮, a testowanym obiektem.

Musimy jawnie oprogramowa膰 to zwi膮zanie by test m贸g艂 przej艣膰 na zielono. Test oczywi艣cie weryfikuje publiczne API serwisu, ale wie te偶 co艣 o jego wewn臋trznej pracy. Zmieniaj膮c zale偶no艣ci serwisu b臋dziemy musieli zaktualizowa膰 testy - dok艂adnie tak samo jak w opisywanym przypadku wykorzystania Closure::bindTo.

Jest jednak subtelna r贸偶nica, w przypadku Closure::bindTo funkcja anonimowa musi dok艂adnie wiedzie膰 w jakim polu znajduje si臋 warto艣膰 czyli po偶膮dana przez nas zmiana stanu. W przypadku weryfikowania mock'贸w za艣, ta informacja w dalszym ci膮gu jest przed nami ukryta, ale niew膮tpliwie w jednym i drugim przypadku odwo艂ujemy si臋 podczas wykonywania asercji do wewn臋trznego stanu obiektu.   

Jak wida膰 ten problem towarzyszy艂 w projekcie w kt贸rym pracuje praktycznie od samego pocz膮tku jego powstania, a mimo to da艂o si臋 z nim 偶y膰 - co wi臋cej - nikt nie uznawa艂 tego za problematyczne. W opisywanym przypadku pojawi艂 si臋 jedynie w nieco innej formie (inny typ testowanego obiektu), ale to dalej nic nowego z czym wcze艣niej si臋 nie borykali艣my.  

馃梼 Dla jakich typ贸w obiekt贸w?

Na samym pocz膮tku musz臋 zauwa偶y膰, 偶e chodzi o zmian臋 stanu obiektu dlatego z tego rozwiazania nale偶a艂oby korzysta膰 tylko w przypadku testowania metod void'owskich. Takich metod nie posiadaj膮 obiekty typu:

❌ Event
❌ DTO
❌ Value Object

Serwisy z metodami void'owskimi te偶 weryfikujemy w inny spos贸b - sprawdzaj膮c ich z'mock'owane zale偶no艣ci, dlatego kolejno odpadaj膮 nam:

❌ Event Subscriber
❌ Command Handler
❌ Serwis Aplikacyjny/Domenowy

To co w艂a艣ciwie pozosta艂o to:

✅ Encja
✅ Agregat 

Lecz tylko w przypadku gdy takowe ju偶 nie udost臋pniaj膮 swojego stanu dla innego kodu produkcyjnego!

馃┗ Inny spos贸b udost臋pniania stanu

Taki sam efekt mo偶naby osi膮gn膮膰 stosuj膮c refleksje:

public function test(): void
{
    $objectUnderTest = new Person('Jan', 'Kowalski');

    // When
    // ...

    $reflection = new ReflectionClass(Person::class);
    $firstNameProperty = $reflection->getProperty('firstName');
    $firstNameProperty->setAccessible(true);
    $lastNameProperty = $reflection->getProperty('lastName');
    $lastNameProperty->setAccessible(true);

    self::assertSame('Jan', $firstNameProperty->getValue($objectUnderTest));
    self::assertSame('Kowalski', $lastNameProperty->getValue($objectUnderTest));
}

W por贸wnaniu z zastosowaniem Closure::bindTo wypada podobnie je偶eli chodzi o podej艣cie czy konsekwencje dla potencjalnego refaktoru. Wi臋cej linii kodu negatywnie wp艂ywa na czytelno艣膰 i w w膮tpliwo艣膰 mo偶emy poddawa膰 szybko艣膰 dzia艂ania, co nie powinno stanowi膰 problemu gdy ten kod tak czy inaczej nie b臋dzie dzia艂a艂 produkcyjnie. 

♻️ Warstwa abstrakcji na asercj臋

Mo偶na by dodatkowo schowa膰 tak膮 implementacj臋 przed testem w customowej klasie Assert. Je偶eli z biegiem czasu pojawi si臋 jaki艣 spos贸b na lepsze udost臋pnianie stanu ni偶 za pomoc膮 Closure::bindTo lub refleksji to sama klasa testowa nie b臋dzie wymaga艂a modyfikacji. Dodatkowo wprowadzenie specjalnej klasy asercji wp艂ynie na popraw臋 czytelno艣ci samego testu.

public function test(): void
{
    $objectUnderTest = new Person('Jan', 'Kowalski');
    
    // When
    // ...
    
    PersonAssert::sameName('Jan', 'Kowalski', $objectUnderTest);
} 

馃摑 Podsumowanie

Koniec ko艅c贸w uwa偶am, 偶e zastosowanie Closure::bindTo by艂o dobrym pomys艂em. Pomimo tego, 偶e udost臋pniamy prywatny stan na zewn膮trz, napisany test jednostkowy przynosi warto艣膰. Co prawda jeste艣my mniej odporni na zmiany klasy poddanej testom, ale z drugiej strony nie mieli艣my zbytniego wyboru. Mogliby艣my u偶y膰 test贸w integracyjnych lecz nie s膮 one tak precyzyjne jak testy jednostkowe. Niekiedy nie dysponujemy takim rozwi膮zaniem w projekcie co uniemo偶liwi艂oby ca艂kowicie otestowanie takiej klasy. Korzystanie z Closure::bindTo powinno by膰 ograniczone tylko do absolutnej konieczno艣ci gdy nie mamy innego wyboru, jest ono obarczone pewnym obci膮偶eniem, ale na tyle ma艂ym by w dalszym ci膮gu utrzyma膰 wszystko w ryzach. 

Jedyne nad czym trzeba si臋 zastanowi膰 to czy weryfikacja dzia艂ania obiektu jest wi臋cej warta ni偶 poni偶sze efekty uboczne:

⚠️ zmiana wewn臋trznego stanu wymaga naprawienia testu
⚠️ zmiana nazwy pola sprawi 偶e komunikat nieprzechodz膮cego testu nie b臋dzie do ko艅ca jasny (UndefinedProperty)
⚠️ narz臋dzia do analizy statycznej mog膮 zg艂asza膰 b艂膮d w zwi膮zku z nieznanym polem


sobota, 22 pa藕dziernika 2022

Komunikacja mi臋dzy Modu艂ami Monolitu: zlecanie prac


Realizacja nowej funkcjonalno艣ci biznesowej cz臋sto wykracza poza ramy jednego Modu艂u Monolitu. Jako 偶e musz膮 si臋 ze sob膮 komunikowa膰 m.in. w celu oddelegowania zada艅 dalej - warto przeanalizowa膰 sobie rodzaje komunikacji jakie mo偶emy zaimplementowa膰.


馃攲 Wariant #1: Fasada

Modu艂 B jest ca艂kowicie zale偶ny od modu艂u A

W tym przypadku modu艂 bie偶膮cy (B) w kt贸rym piszemy zlecon膮 nam funkcjonalno艣膰 musi oddelegowa膰 cz臋艣膰 prac do innego zewn臋trznego modu艂u (A). Delegowanie pracy w praktyce polega na wywo艂aniu void'owskiej metody (Command) Fasady le偶膮cej w zewn臋trznym module

W opisywanym przypadku modu艂 bie偶膮cy jest tym znajduj膮cym si臋 w dole strumienia. Ca艂kowicie musi si臋 on podda膰 kontraktowi komunikacji ustanowionego przez upstream'owy modu艂 zewn臋trzny. Modu艂 A wie jakich sk艂adnik贸w b臋dzie potrzebowa艂 do wykonania swojego zadania, dlatego stanowi膮 one parametry metody Fasady. W gestii modu艂u downstream'owego le偶y to by takowe parametry dostarczy膰 - warto si臋 zastanowi膰 czy posiadanie przez niego takich informacji jest w og贸le poprawne. 

Warto podkre艣li膰, 偶e modu艂 A nie wie nic o swoich klientach - udostepnia API (Interfejs Fasady) do komunikacji z innymi modu艂ami i nie dba o to czy jest ich pi臋ciu czy nie ma ani jednego. W tym przypadku to modu艂 zewn臋trzny A jest niezale偶ny od innych modu艂贸w. Id膮c tym tropem: odpowiedzmy sobie najpierw na pytanie dlaczego modu艂 bie偶膮cy B do wykonania w pe艂ni swojej funkcjonalno艣ci musi oddelegowa膰 cz臋艣膰 pracy do zewn臋trznego modu艂u - czy granice zosta艂y poprawnie wytyczone?

Modu艂 B z kolei wie dok艂adnie o istnieniu innego modu艂u A i jak si臋 z nim komunikowa膰 (API Fasady). Jest to wi臋c jawna deklaracja komunikacji jednostronnej: 

  • wiem co chc臋 zrobi膰,
  • wiem kto to zrobi,
  • wiem dok艂adnie jak zmusi膰 tego kogo艣 do wykonania tej czynno艣ci.


馃摠 Wariant #2: Event'y

W tym wypadku modu艂 bie偶膮cy (A) w kt贸rym dodajemy funkcjonalno艣膰, informuje inne bli偶ej nieokre艣lone modu艂y o zaistnieniu pewnego zdarzenia wewn膮trz swoich granic. Robi to emituj膮c Event Aplikacyjny (Sync/Async) - nie troszcz膮c si臋 o to kiedy i przez kogo zostanie on obs艂u偶ony.  

Modu艂y B i C s膮 ca艂kowicie zale偶ne od Modu艂u A

Zaimplementowanie Event'u w Warstwie Aplikacji wychodz膮cego poza granic臋 bie偶膮cego modu艂u jest swego rodzaju zdefiniowaniem kontraktu komunikacji

Modu艂 bie偶膮cy (A) nie dba o to czy Event'y zostan膮 obs艂u偶one, istotne jest to tylko dla zewn臋trznych modu艂贸w (downstream'owych) kt贸re decyduj膮 si臋 na nas艂uchiwanie na tego typu zdarzenia.

Downstream'owe modu艂y B i C musz膮 dostosowa膰 si臋 do kontraktu ustalonego przez modu艂 A. Musz膮 one by膰 w stanie wykona膰 swoj膮 prac臋 na postawie danych znajduj膮cych si臋 w Event'cie. 

W tym wypadku, nie mo偶emy powiedzie膰 偶e modu艂 A chce oddelegowa膰 cz臋艣膰 pracy do innych modu艂贸w. Jedynie daje im zna膰, 偶e co艣 si臋 u niego zdarzy艂o. 

Jest to wi臋c ca艂kowicie inna sytuacja ni偶 gdyby mia艂 on skorzysta膰 z Fasad modu艂贸w B & C wywo艂uj膮c ich metody void'owskie. 

Mo偶naby ponownie wypisa膰 stwierdzenia jak w przypadku poprzedniej sekcji - Stan bie偶膮cego modu艂u uleg艂 zmianie:

  • nie wiem kogo to interesuje,
  • nie wiem czy b臋dzie mia艂o to jakiekolwiek konsekwencje.


馃攷 Por贸wnanie

W przypadku korzystania z Fasady niejawnie zak艂adamy, 偶e co艣 musi si臋 zadzia膰 i nie mo偶emy obej艣膰 si臋 bez tej funkcjonalno艣ci z zewn臋trznego modu艂u. Wydaje si臋, 偶e wybieraj膮c takie rozwi膮zanie funkcjonalno艣膰 wykonywana za Fasad膮 (upstream) jest naprawd臋 wa偶na. 

W przypadku emitowania Event'贸w przez modu艂 bie偶膮cy - nie dbamy o to jaki klient/klienty obs艂u偶膮 to zdarzenie. Zastanawiam si臋 czy z takim podej艣ciem, obs艂uguj膮ce to zdarzenie modu艂y downstreamo'we wykonuj膮 funkcjonalno艣ci drugorz臋dne... tak - ale tylko z perspektywy bie偶膮cego modu艂u.

Bie偶膮cy modu艂 komunikacja z Fasad膮 emitowanie Event’贸w
Hierarchia downstream upstream
Czy tworzy kontrakt nie tak
Czy wie kto b臋dzie wykonywa艂 czynno艣膰 tak nie
Czy mamy pewno艣膰 wykonania zleconych prac tak nie
Czy konsekwencje prac s膮 znane tak nie
Spos贸b komunikacji Sync Sync/Async

Modu艂y w Niebieskiej Ksi膮偶ce Eric'a Evans'a


Large Scale Domain Concept

 
Eric sugeruje by rozpatrywa膰 modu艂y jako bloki budulcowe taktycznego DDD takiej samej rangi jak Agregaty, Encje czy Value Object'y. Jest to koncept wi臋kszej skali, grupuj膮cy inne mniejsze powi膮zane ze sob膮 koncepty domenowe. Od strony kodu 藕r贸d艂owego modu艂y b臋d膮 reprezentowane przez konkretne namespace'y zawieraj膮cy obiekty i interfejsy.
  
Modu艂 pochodzi z modelu domenowego, a jego nazwa z Ubiquitous Language - nie powinien wi臋c on by膰 tylko elementem kodu 藕r贸d艂owego s艂u偶膮cego do zredukowania z艂o偶ono艣ci. U艂atwia to komunikacj臋 z ekspertami domenowymi poniewa偶 mo偶emy szybko ustali膰 kontekst poruszanego problemu czy te偶 pos艂ugiwa膰 si臋 bardziej og贸lnym poj臋ciami rozumianymi przez ka偶d膮 ze stron.

Modu艂 skupiaj膮cy mniejsze domenowe poj臋cia
Spogl膮daj膮c na aplikacj臋 z lotu ptaka, wprowadzone modu艂y sprawiaj膮, 偶e zyskujemy now膮 perspektyw臋 wgl膮du w tworzony system. Mo偶emy spojrze膰 na to w jaki spos贸b koncepty wi臋kszej skali ze sob膮 wsp贸艂pracuj膮, bez niepotrzebnego rozpraszania si臋 z艂o偶ono艣ci膮 (liczne klasy i interfejsy) kt贸r膮 heremtyzuj膮. 

Mo偶liwo艣膰 spojrzenia na aplikacj臋 monolityczn膮 z wysoko艣ci nie jest spraw膮 oczywist膮 i dost臋pn膮 od tak. Najpierw nale偶y wykona膰 prac臋 analizuj膮c膮 dok艂adn膮 zawarto艣膰 modu艂贸w oraz ustali膰 relacj臋 mi臋dzy nimi nazwi膮zane. Niew膮tpliwie jest to op艂acalna inwestycja poniewa偶 daje nam mo偶liwo艣膰 lepszego zrozumienia domeny problemu. Na podstawie takiego przegl膮du mo偶emy doj艣膰 do wniosku, 偶e niekt贸re z modu艂贸w maj膮 zbyt du偶o odpowiedzialno艣ci lub relacje mi臋dzy modu艂ami s膮 nielogiczne lub dwukierunkowe.    


Relacje z innymi Modu艂ami 

Relacje mi臋dzy modu艂ami

Dziel膮c klasy i interfejsy na modu艂y wartoby by艂o monitorowa膰 ich relacje z innymi modu艂ami. Nie powinni艣my rozpatrywa膰 zale偶no艣ci modu艂贸w mi臋dzy sob膮 jako co艣 z艂ego, to normalne 偶e komunikuj膮 si臋 ze sob膮 nawzajem. Relacj臋 mo偶na traktowa膰 jako element modelu i warto艣膰 sam膮 w sobie.
 
Uwa偶nie 艣ledz膮c kierunek relacji modu艂贸w mo偶emy sprawdzi膰 w jaki spos贸b modu艂y s膮 od siebie zale偶ne. Powinni艣my pilnowa膰 by liczba relacji w module lokalny do modu艂贸w zewn臋trznych by艂a jak najmniejsza i jednokierunkowa. Je偶eli tak nie jest to warto przeanalizowa膰 funkcjonalno艣ci w innych modu艂ach od kt贸rych modu艂 lokalny jest zale偶ny. 
 
Je偶eli koncept domenowy z modu艂u zewn臋trznego jest sp贸jny z tymi znajduj膮cymi si臋 w module lokalnym wszystko wskazuje na to, 偶e to w nim powinna by膰 umiejscowiona funkcjonalno艣膰. 


Low Coupling & High Cohesion

 
Zasada jak najmniejszej ilo艣ci powi膮za艅 (Low Coupling) jest 艣ci艣le zwi膮zana z zasad膮 wysokiej sp贸jno艣ci (High Cohesion) koncept贸w/regu艂/logiki. Je偶eli modu艂 ma wiele powi膮za艅 z innymi modu艂ami (High Coupling) to znaczy, 偶e funkcjonalno艣ci dotycz膮ce jednej dziedziny problemu zosta艂y rozbite na kilka modu艂贸w - st膮d potrzeba wielu powi膮za艅 mi臋dzy nimi. 
 
Istotn膮 korzy艣ci膮 p艂yn膮c膮 ze stosowania si臋 do tych zasad jest fakt, 偶e o wiele 艂atwiej pracowa膰 z wysoce sp贸jnymi i lu藕no powi膮zanymi modu艂ami. Programi艣ci wprowadzaj膮cy zmiany w takim obszarze b臋d膮 mieli do czynienia z klasami reprezentuj膮cymi tylko konkretn膮 cz臋艣膰 domeny. 
 
Liczba klas w module b臋dzie wi臋c ograniczona, dlatego nie powinni艣my by膰 przeci膮偶eni kognitywnie analizuj膮c je wszystkie razem w celu zrozumienia pe艂nego konceptu. Ewentualne powi膮zania do innych byt贸w b臋d膮 nieliczne i jasno zdefiniowane.   
       
Warto zwr贸ci膰 uwag臋, 偶e pilnowanie by implementowany byt by艂 lu藕no powi膮zany i wysoce sp贸jny powinni艣my stosowa膰 zar贸wno podczas pracy z modu艂ami jak i obiektami - zasada jest uniwersalna.


Ci膮g艂y Refactor

 
Tak jak pozosta艂e building block'i taktycznego DDD wymagaj膮 przeprowadzania ci膮g艂ej refaktoryzacji - tak samo powinni艣my post臋powa膰 z modu艂ami. 
 
W przypadku modu艂贸w refaktoryzacji zazwyczaj powinno by膰 poddawane umiejscowienie koncept贸w/regu艂/logiki w nich zawartych. Je偶eli 艂amiemy zasad臋 wysokiej sp贸jno艣ci powinni艣my przenie艣膰 funkcjonalno艣膰 do innego modu艂u. 
 

Modu艂 A posiada niesp贸jny koncept


Kiedy 偶aden z istniej膮cych modu艂贸w nie wydaje si臋 wystarczaj膮co odpowiednim miejscem nale偶y rozwa偶y膰 utworzenie nowego modu艂u. Wskaz贸wki co do jego potencjalnej nazwy mo偶e da膰 rozmowa przeprowadzona z przedstawicielem biznesu. Zazwyczaj jest to wcze艣niej nieodkryty b膮d藕 niejawny koncept domenowy.

Jak zauwa偶a Evans, programi艣ci nie s膮 skorzy do przeprowadzania refaktoru modu艂贸w i zadowalaj膮 ich granice/nazwy ustalone na samym pocz膮tku ich powstania, a jak cz臋sto wspomina艂, pierwotny model jest zazwyczaj naiwny.
 
Mo偶na wyci膮gn膮膰 wnioski, 偶e s膮 one k艂opotliwe do refaktoru poniewa偶:
  • wymagaj膮 znacznie wi臋kszego zakresu prac ni偶 refaktor obiekt贸w,
  • wymagaj膮 spojrzenia na kod z innej perspektywy w celu dostrze偶enia ewentualnych miejsc do poprawy,  
  • trudno wpa艣膰 na lepszy pomys艂 podzia艂u na modu艂y
    b膮d藕 programi艣ci w og贸le nie bior膮 pod uwag臋 tego, 偶e ten aspekt projektu m贸g艂by zosta膰 ulepszony.
Warto wi臋c rozpatrywa膰 nast臋puj膮ce aspekty modu艂贸w i zastanowi膰 si臋 nad ich poprawno艣ci膮:
  • granice, 
  • nazewnictwo, 
  • ukryte koncepty, 
  • nieaktualne byty.
 
Powinni艣my liczy膰 si臋 z tym, 偶e prace refaktoryzacyjne w tych obszarach nie b臋d膮 tak cz臋sto przeprowadzane i same modu艂y pod wzgl臋dem ich aktualno艣ci "b臋d膮 sta艂y w tyle" za reszt膮 koncept贸w.  


Opracowanie na podstawie

馃摎 Eric Evans "Domain Driven Design: Tackling Complexity in the Heart of Software" str. 109-115.

sobota, 15 pa藕dziernika 2022

Mockowanie Repozytori贸w

Testowanie jednostkowe klas posiadaj膮cych jako zale偶no艣ci Repozytoria np. Seriws贸w/Command Handler'贸w mo偶e by膰 k艂opotliwe. Je偶eli zdycydujemy si臋 na sztuczne implementacje Repozytori贸w tzw. *InMemoryRepository – powinni艣my by膰 艣wiadomi kwestii zwi膮zanych z ich p贸藕niejszym utrzymaniem – jakie problemy rozwi膮zuj膮, a jakie stwarzaj膮. Kod metody poddawanej testom nie jest tym nad czym chacia艂bym si臋 skupi膰 w tym wpisie, istotne jest jedynie wywo艂anie w niej metody Query (CQS) Repozytorium.


Podej艣cia do Mock’owania Repozytori贸w

Na potrzeby testu jednostkowego musimy odtworzy膰 wiern膮 kopi臋 klasy produkcyjnej. Np. posiadamy interfejs repozytorium OrderRepository:

interface OrderRepository 
{
	/** @return Order[] */
	public function getUnpaidOrders(): iterable;
}


Abstrahuj膮c od tego jak wygl膮da艂aby implementacja klasy produkcyjnej OrderMySQLRepository, skupmy si臋 na jej odpowiedniku utworzonym na potrzeby testu:

final class OrderInMemoryRepository implements OrderRepository
{
	/** @param Order[] $orders */
	public function __construct(private array $orders) {}
	
	public function getUnpaidOrders(): iterable
	{
		return array_filter(
			$this->orders,
			static fn ($order) => $order->isUnpaid() 
		);
	}
}


Implementacja metody OrderInMemoryRepository::getUnpaidOrders zosta艂a tak napisana by zawsze zwraca艂a odpowiedni膮 kolekcj臋 zam贸wie艅 - logicznie zgodn膮 z nazw膮 metody. Dzi臋ki takiej implementacji dysponujemy ca艂kiem por臋cznym narz臋dziem do pisania test贸w jednostkowych. W przypadku gdy interfejs posiada艂by by inne metody – te偶 w takim stopniu odtwarzaj膮ce rzeczywist膮 implementacj臋 – mogliby艣my u偶ywa膰 tego samego obiektu OrderInMemoryRepository w wielu przypadkach testowych. Jest to do艣膰 z艂o偶ony TestDouble typu Fake, kt贸ry niejako posiada wi臋dz臋 na temat tego jak dzia艂a produkcyjna implementacja.

Mogliby艣my przyj膮膰 inn膮 taktyk臋 w kt贸rej OrderInMemoryRepository jest maksymalnie okrojony z implementacji:

final class OrderInMemoryRepository implements OrderRepository
{
	/** @param Order[] $orders */
	public function __construct(private array $orders) {}
	
	public function getUnpaidOrders(): iterable
	{
		return $this->orders;
	}
}


Jako, 偶e OrderInMemoryRepository::getUnpaidOrders zawsze zwraca tak膮 sam膮 kolekcj臋 jak ta dostarczona do konstruktora – mo偶na powiedzie膰, 偶e jest to pewna forma Stub’a.Ci臋偶ar doboru odpowiednich danych wej艣ciowych spoczywa na metodzie w kt贸rej sztuczne Repozytorium zosta艂o utworzone – np. Fixtura, metoda testowa/setUp.

Korzystanie z wariantu Stub jest niemal identyczne jakby艣my u偶ywali biblioteki mokuj膮cej np. MockObject czy Prophecy. W dw贸ch przypadkach musimy staranie dobra膰 zwrotk臋 metody do aktualnego przypadku testowego. Pomi臋dzy przygotowan膮 kolekcj膮 obiekt贸w wrzucan膮 w metod臋 obiektu z biblioteki mokuj膮cej/czy konstruktorem Stub *InMemoryRepository, a zwr贸ceniem danych z wywo艂anej metody Repozytorium, nic wi臋cej si臋 nie dzieje - nie nast臋puje 偶adne filtrowanie.

Fake Repository

❌ jest silnie sprz臋偶ony z Produkcyjnym Repozytorium (po ka偶dej zmianie repozytorium MySQL, musimy sprawdzi膰 czy *InMemoryRepository nie wymaga modernizacji, czy w dalszym ci膮gu wiernie odzwierciedla prawdziw膮 implemetacj臋),

✅ koncept stoj膮cy za nazw膮 metod jest jawnie zapisany w kodzie,

✅ odpowiednio przygotowany mo偶e by膰 wykorzystany w wielu przypadkach testowych.


Stub Repository

❌ musi by膰 indywidualnie przygotowany pod ka偶dy przypadek testowy. Dob贸r zwrotek jego metod stoi po stronie developera – jest wi臋c nie do ko艅ca jawny,

❌ w przypadku zmiany metody Produkcyjnego Repozytorium, musimy zweryfikowa膰 wszystkie przypadki testowe kodu, kt贸ry bezpo艣rednio polega na tej metodzie. Czy w dalszym ci膮gu przygotowane przez developera obiekty zwracane przez metod臋 sztucznego Repozytorium spe艂niaj膮 logik臋 kt贸ra stoi za ich nazw膮? 

✅ zalet膮 jest mniej kodu do utrzymania, ale to tylko dlatego, 偶e koncepty te nie s膮 zawarte w kodzie z czego wynikaj膮 opisane wy偶ej problemy. W przypadku gdy istnieje tylko jeden klient metody Repozytorium mo偶emy zastosowa膰 Stub’a – wraz z rozrostem repozytorium o nowe metody, zwi臋kszeniem si臋 liczby klient贸w nale偶y rozwarzy膰 refaktoryzacj臋 w stron臋 Fake’a.

Koniec ko艅c贸w, czy stosujemy jedn膮 czy drug膮 metod臋 – ca艂y czas jeste艣my w tej samej sytuacji – musimy inscenizowa膰 dostarczanie danych do testowanej metody. W przypadku Fake’贸w z bardziej skomplikowan膮 implementacj膮, dysponujemy po prostu bardziej wszechstronnym narz臋dziem kosztem jego p贸藕niejszego utrzymania. 


Utrzymanie klasy Fake InMemory Repository


Nowe wymagania biznesowe w czasie kolejnych iteracji wymuszaj膮 zmian臋 repozytori贸w - prawdziwych i sztucznych.

Przedstawione na diagramie zmiany interfejsu Repozytorium, s膮 oczywi艣cie nap臋dzane decyzjami biznesu co do nowych feature’贸w. Jak wida膰 testuj膮c jednostkowo metod臋 wywo艂uj膮c膮 metody Repozytorium, musimy wprowadzi膰 do systemu testowego nowy byt. Ka偶da zmiana implementacji repozytori贸w b臋dzie wymusza艂a na nas prace zwi膮zane z jego utrzymaniem. Mo偶na wywnioskowa膰, 偶e klasy *InMemoryRepository to dodatkowy koszt jaki musimy ponie艣膰 za cen臋 bezpiecze艅stwa czyli 艂atwiejszego wprowadzania zmian w projekcie.

B艂臋dne b臋dzie jednak za艂o偶enie, 偶e Mock’owanie Repozytori贸w zawsze daje nam wspomniane bezpiecze艅stwo. W przypadku gdy pomi臋dzy Klas膮 Produkcyjn膮, a Test Double pojawi膮 si臋 rozbie偶no艣ci w dzia艂aniu – wprowadzone nie艣wiadomie/omy艂kowo przez programist臋 – testy jednostkowe mog膮 przechodzi膰 na zielono, podczas gdy tzw. Produkcja b臋dzie rzuca艂 b艂臋dami lub dzia艂a艂a niezgodnie z oczekiwaniami. Jest to ryzyko z kt贸rego powinni艣my zdawa膰 sobie spraw臋 podczas synchronizacji Fake InMemory Repository z Repozytorium Produkcyjnym.

Warto te偶 zauwa偶y膰, 偶e im bardziej uniwersalna jest metoda repozytorium tzn. posiada filtry, tym trudniej utworzy膰 jej imitacj臋 potrzebn膮 do test贸w jednostkowych. Odtworzenie poprawnego zachowania wszystkich filtr贸w mo偶e by膰 skomplikowane, a wprowadzona z艂o偶ono艣膰 z tym zwiazana - podatna na b艂臋dy w przysz艂o艣ci. Przy tego typu pracach nale偶y zachowa膰 szczeg贸ln膮 ostro偶no艣膰, gdy偶 jak na ironi臋, nie posiadamy testu jednostkowego klasy InMemory.

Je偶eli za艣 chodzi o sam design, na tak uniwersalnej metodzie Repozytorium polega膰 b臋dzie zapewne du偶o klient贸w, co b臋dzie skutkowa艂o pojawieniem si臋 zale偶no艣ci mi臋dzy nimi czego wsp贸lnym mianownikiem jest wspomniana „uniwersalna” metoda Repozytorium.


Podej艣cie funkcyjne

Mo偶emy przyj膮膰 zupe艂nie inn膮 taktyk臋. Zamiast zastanawia膰 si臋 nad najlepszym sposobem testowania metod kt贸re pozyskuj膮 dane z repozytori贸w - nie testowa膰 ich w og贸le. Wi膮偶e si臋 to z destylacj膮 logiki biznesowej zawartej w testowanej metodzie poprzez wydzielenie wszystkich wyow艂a艅 metod Query (CQS) do warstwy wy偶ej.

Metoda Serwisu samy pozyskuje dane z Repozytorium. Taka implementacja wymaga ich mock'owania.


W wyniku takiej zmiany design’u: wydestylowany byt staje si臋 Serwisem Domenowym, a warstwa kt贸ra pozyskuje Encj臋/Agregaty/VO z repozytori贸w – Serwisem Aplikacyjnym, kt贸rego domenowy odpowiednik otrzymuje wszystkie potrzebne do przeprowadzenia operacji obiekty, jako parametry metody.


Testowany Serwis Domenowy poddawany nie wie nic o klasach Repozytori贸w.

Testowaniu jednostkowem podlega膰 b臋dzie wtedy tylko Serwis Domenowy, dla kt贸rego nie b臋dziemy musieli ju偶 szykowa膰 偶adnego Test Double Repozytorium. Serwisy Aplikacyjne b臋d膮 testowane tylko Integracyjne.

Niekt贸re przypadki mog膮 okaza膰 si臋 problematyczne do zaimplementowania – bo jak mamy rozwi膮za膰 problem jakiego艣 bytu kt贸ry jest pobierany z repozytorium na podstawie jakiej艣 decyzji biznesowe?

Podsumowanie

Jak wida膰 mockowanie repozytori贸w wi膮偶e si臋 z pewnego rodzaju problemami z kt贸rych nale偶y sobie zdawa膰 spraw臋 – jak zwykl臋 w programowaniu nic nie jest czarno bia艂e i rozwi膮zuj膮c pewien problem godzimy si臋 na wprowadzenie mniejszego. Testy Integracyjne niejako rozwi膮zuj膮 spraw臋 tworzenia Test Double Repozytori贸w w og贸le, niemniej jednak nie zawsze takowe z 艂atwo艣ci膮 mo偶na wprowadzi膰 w projekcie.


Metoda Prywatna vs. Value Object

馃敀 Metoda Prywatna

Na samym pocz膮tku musimy odpowiedzie膰 sobie na pytanie dlaczego tworzymy metody prywatne:

  • potrzebujemy wsp贸艂dzieli膰 kod w conajmniej dw贸ch innych metodach danej klasy,
  • chcemy zredukowa膰 z艂o偶ono艣膰 i ukry膰 pewny sp贸jny logicznie kawa艂ek kodu,

Niew膮tpliwie s膮  to dobre powody, ale stosowanie metody prywatnej nie jest najlepszym sposobem na uwsp贸lnianie kodu czy redukowania jego z艂o偶ono艣ci.  


馃挕 Narodziny Konceptu Domenowego

Mamy klas臋 ShippingService z metod膮 publiczn膮 getCost zwracaj膮c膮 cen臋 wysy艂ki. W samym ciele tej metody zaczyna rosn膮膰 ilo艣膰 linii kodu weryfikuj膮cego czy dostawa powinna by膰 darmowa czy nie. Logika nie jest banalna i na podstawie nowych wytycznych biznesu koncept darmowej wysy艂ki jest dopiero implementowany w kodzie.

final class ShippingService 
{
	public function getCost(...): Money 
	{
		// call private method
	}

	private function isFree(...): bool 
	{
		// using class dependencies
	}
}

Nie wchodz膮c w szczeg贸艂y implementacji, skupmy si臋 na samym fakcie powstania nowej metody prywatnej ShippingService::isFree - czyli zredukwaniu z艂o偶ono艣cie metody g艂贸wnej ShippingService::getCost. Metoda prywatna enkapsuluje warunki podejmuj膮ce decyzj臋 czy wysy艂ka jest darmowa. Wy艂oni艂 si臋 tutaj nowy koncept domenowy i niestety jest on zamodelowany za pomoca metody prywatnej.

Problem pojawia si臋 gdy inny serwis r贸wnie偶 b臋dzie musia艂 operowa膰 na koncepcie darmowej wysy艂ki. W tym wypadku potrzebny by艂by refaktor - upublicznienie metody b膮d藕 wydzielenie jej do nowego serwisu nie wydaje si臋 te偶 dobrym rozwi膮zaniem. Wi臋c je偶eli pozostawimy to w obecnej formie musimy liczy膰 si臋 z nast臋puj膮cymi konsekwencjami:     

❌ niemo偶liwe jest ponowne wykorzystanie metody w innym obszarze,

❌ istnieje ryzyko duplikacji logiki - 艣wiadomej (przez lenistwo programisty) / nie艣wiadomej (trudniej odnale藕膰 logik臋 w metodzie prywatnej ni偶 w osobnej klasie).

❌ modelowanie koncept贸w domenowych za pomoc膮 metod serwisowych ogranicza nasze mo偶liwo艣ci co do rozwoju koncept贸w kt贸re odzwierciedlaj膮. 

Koncept domenowy jest ukryty


⚠️ Metoda jako wyra偶anie Konceptu Domenowego

Przechowywanie koncept贸w domenowych w metodach jest bardzo ograniczaj膮ce w ich potencjalnym dalszym rozwoju. Istnieje bardzo du偶a szansa, 偶e sam koncept domenowy z czasem b臋dzie si臋 rozwija艂 nabieraj膮c pe艂niejszego kszta艂tu. 

Je偶eli obecnie oczekujemy tylko odpowiedzi na to czy dla danej kwoty wysy艂ka jest darmowa to w przysz艂o艣ci mo偶emy potrzebowa膰 np. samego progu cenowego darmowej wysy艂ki. Wymaga艂oby to od nas utworzenia kolejnej wyspecjalizowanej metody. 

Co wi臋cej przy nieznajomo艣ci projektu mo偶emy mie膰 problemy z ustaleniem czy taki byt w og贸le istnieje w projekcie - z perspektywy katalog贸w jest on niewidoczny. 

Dodatkowo cementujemy logik臋 biznesow膮 wraz ze sposobem pozyskiwania danych (pobieranie danych z repozytorium) co mo偶e prowadzi膰 do ich parametryzacji b膮d藕 wydzielenia cz臋艣ci logiki do kolejnych metod prywatnych.


馃З Value Object

Nie jest to wpis o Value Object'cie samym w sobie dlatego tylko wypisz臋 jego przewagi wzgl臋dem stosowania metod serwisowych:

  • jest uniezale偶niony od kontekstu wywo艂ania,
  • nazwa klasy mo偶e nada膰 mu bardziej abstrakcyjny charakter (metoda shippingDays na Value Object ShippingTime::days),  
  • bardzo 艂atwy w testowaniu,
  • jawna i niezale偶na jednostka przechowuj膮ca wiedz臋 domenow膮,
  • widoczny z poziomu katalog贸w,  
  • bardzo 艂atwy do ponownego wykorzystania w innym obszarze. 


♻️ Refaktoryzacja do Value Object

Pierwszym etapem refaktoryzacji do Value Object'u mo偶e by膰 transformacja do prywatnej metody statycznej. W tym wypadku wszystkie parametry wej艣ciowe sta艂yby si臋 w dalszym toku przekszta艂ce艅 parametrami konstruktora Value Object'u.

Przenosz膮c odpowiedzialno艣ci do Value Object'u i powi膮zanej z nim Fabryki redukujemy z艂o偶ono艣c samego Serwisu w kt贸rym logika ta si臋 wcze艣niej znajdowa艂a. Zale偶no艣ci przechodz膮 z Serwisu do Fabryki i to w艂a艣nie ona od teraz jest wstrzykiwana do klasy Serwisowej. 

Przekszta艂cenie metody prywatnej na Value Object